
Met GA4-export naar BigQuery plus de Google Ads Data Transfer Service koppel je advertentieklikken, kosten en ruwe eventdata aan elkaar via de GCLID. Zo meet je de werkelijke kostprijs per lead in plaats van een schatting uit de GA4-interface. De eerste stap is simpel: schakel de BigQuery-export in, configureer de Ads Data Transfer Service en controleer meteen of GCLID’s daadwerkelijk in je events terechtkomen.
Kort samengevat:
- Alleen de ruwe BigQuery-data geeft de werkelijke kosten per lead weer, omdat de GA4-interface verwerktormulaties al afwijkingen kunnen veroorzaken.
- Het koppelen van GCLID’s tussen GA4 en Google Ads-tabellen vereist deduplicatie, windowing van event-tijden en filtering op datums om correcte attributie te garanderen.
- Bij ‘Data not available’ in het traffic source veld moet je een backfillproces opzetten dat ontbrekende gegevens automatisch aanvult, vooral bij snelle of automatische exports.
- Het frequent controleren van tabellen op schema-wijzigingen en schema-versie helpt preventief kapotte dashboards en stijgende kosten te voorkomen.
- Concreet meet je kostprijs per lead door klikken uit Google Ads te koppelen aan geverifieerde leads uit CRM, met optimale filters voor kosten-baten en leadkwaliteit.
Inhoudsopgave
- Wat bevat de GA4-export naar BigQuery precies?
- Hoe werkt de Google Ads Data Transfer Service?
- Hoe koppel je GA4-events aan Ads-clicks via GCLID?
- Wat betekent ‘Data Not Available’ en hoe vul je dat aan?
- Welke queries en metrics leveren direct waarde op voor leadgeneratie?
- Hoe voorkom je onnodige BigQuery-kosten?
- Implementatiechecklist: van inschakelen tot dagelijkse routine
- Waarom Adworth deze aanpak adviseert voor B2B-leadgeneratie
- Hulp nodig bij implementatie en dagelijks beheer?
- Bronnen
- Veelgestelde vragen
Wat bevat de GA4-export naar BigQuery precies?
GA4 zet elke dag een dataset klaar in je Google Cloud project met de naam analytics_<property_id>. Daarin vind je per dag een tabel, gepartitioneerd op event_date, met alle events op het niveau van individuele gebeurtenissen. Geen samengevatte cijfers zoals in de GA4-interface, maar rauwe rijen: één regel per klik, scroll, formulierverzending of paginaweergave.
Voor advertentieanalyse zijn een paar velden onmisbaar:
- event_timestamp en event_date: exacte tijdstip en datum van de gebeurtenis, nodig voor windowing bij joins.
- traffic_source en collected_traffic_source: hier zit de herkomst van het bezoek, inclusief het veld
gcliddat je straks koppelt aan Ads-data. - session_traffic_source_last_click: de laatst bekende attributiebron van de sessie, handig als vergelijkingspunt.
- user_pseudo_id en user_id: identificatoren om gebruikersreizen te reconstrueren over meerdere sessies.
Hier zit meteen de eerste valkuil. De BigQuery-export bevat ruwe, onbewerkte events. De GA4-interface daarentegen toont gemodelleerde data: Google Signals vult ontbrekende gebruikersinformatie aan, en attributiemodellen verdelen conversiewaarde over meerdere touchpoints. Dat verklaart waarom een cijfer in de GA4-interface bijna nooit exact overeenkomt met wat je in BigQuery optelt, zoals Google zelf uitlegt in de uitleg over verschillen tussen UI en BigQuery-export. Voor leadgeneratie is dat geen nadeel. Je wilt juist de ruwe, ongemodelleerde waarheid, niet Google’s interpretatie ervan.
Hoe werkt de Google Ads Data Transfer Service?
De Google Ads Data Transfer Service haalt automatisch je campagnedata op en zet die in BigQuery neer, zonder dat je zelf exports hoeft te draaien. De transfer levert een reeks tabellen op, waaronder ads_ClickStats_, campagne en accountoverzichten, en tabellen met conversiegegevens per advertentiegroep en zoekwoord. De exacte kolomstructuur per rapporttype staat in de officiële documentatie over Google Ads-rapporttransformatie.
Een paar praktische punten voordat je dit inricht:
- De transfer laadt data in tabellen die per datum gepartitioneerd zijn, waardoor je bij herhaalde imports geen dubbele rijen krijgt, zoals beschreven in de Google Cloud documentatie over de Ads-transfer.
- Google Ads API-versies veranderen regelmatig, en dat kan schema’s van tabellen wijzigen. Een kolom die vandaag
campaign_idheet, kan na een API-upgrade een andere naam of structuur krijgen. - Je hebt de juiste rechten nodig op zowel het Google Ads-account als het BigQuery-project: minimaal leestoegang op Ads en schrijftoegang op de dataset.
- Kies bewust in welk project en welke dataset je de transfer laat landen. Een apart project voor advertentiedata voorkomt gedoe met toegangsrechten later.
Pro-tip: Zet een losse tabel met “laatst gecontroleerde schema-versie” op, en check die maandelijks tegen de actuele Ads API-documentatie. Een stille schemawijziging is de meest voorkomende oorzaak van kapotte dashboards die niemand meteen opmerkt.
Hoe koppel je GA4-events aan Ads-clicks via GCLID?
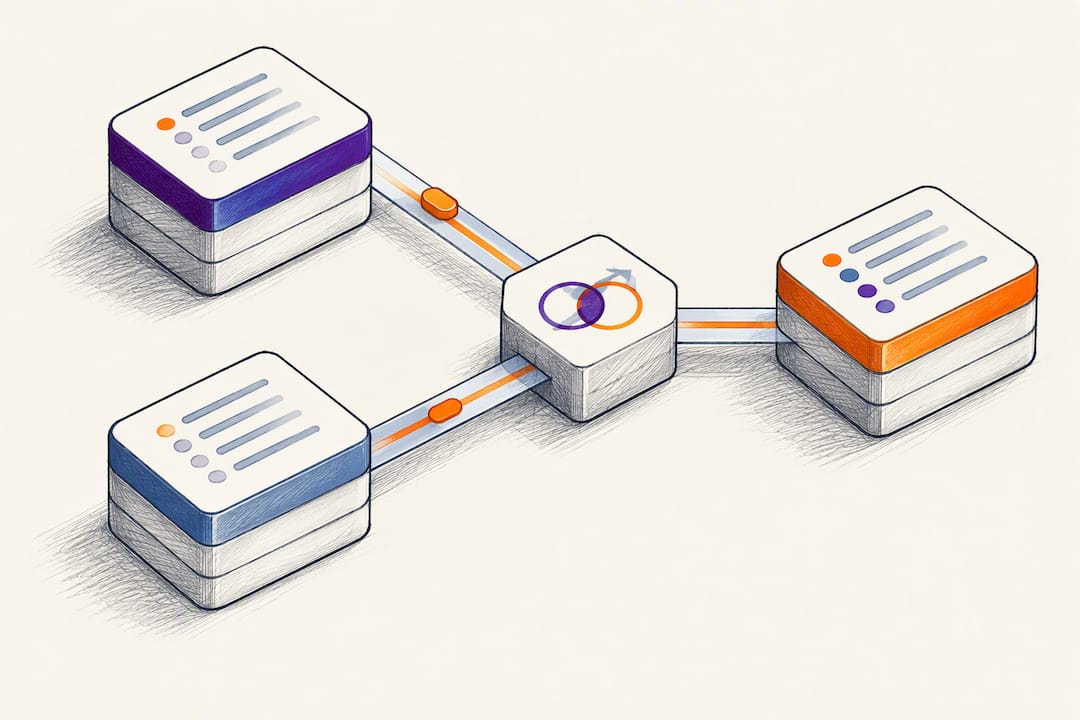
De GCLID is de spil van je hele attributieketen. Zonder die koppeling meet je losse fragmenten: wel advertentiekosten, wel websitegedrag, maar nooit het verband ertussen. Google adviseert zelf om collected_traffic_source.gclid uit de GA4-export te koppelen aan het gclid-veld in ads_ClickStats_ uit de Ads-transfer, zoals te lezen valt in de gids met basisqueries voor GA4-eventdata.
Drie dingen bepalen of die join klopt:
- Deduplicatie van clicks. De
ads_ClickStats_-tabel kan meerdere rijen per GCLID bevatten, bijvoorbeeld door herhaalde metingen. Kies de click met het vroegste tijdstip of bouw een rankinglogica op click_id, anders tel je advertentiekosten dubbel. - Windowing op event_timestamp. Een gebruiker klikt niet altijd meteen door naar een conversie. Bepaal een redelijk tijdvenster (vaak 24 tot 72 uur) waarbinnen je een GA4-event nog aan de oorspronkelijke click toeschrijft.
- Filteren op partities. Omdat beide tabellen per datum gepartitioneerd zijn, filter je altijd expliciet op een datumrange in je
WHERE-clausule. Dat scheelt niet alleen kosten, het voorkomt ook dat je per ongeluk maanden aan data doorzoekt voor een simpele controle.
Conceptueel ziet de keten er zo uit: je start bij de Ads-clicktabel, joint die op gclid met de GA4-eventtabel om te zien welke sessies uit die click voortkwamen, en koppelt vervolgens de conversie-events aan je CRM-export op basis van een lead-ID of e-mailhash die je server-side hebt vastgelegd. Zo weet je niet alleen dat een klik tot een formulierinzending leidde, maar ook of die lead later daadwerkelijk een geverifieerd contact of klant werd.
Pro-tip: Bouw de join niet telkens opnieuw in een losse query. Zet een gemodelleerde tussenlaag neer, bijvoorbeeld een geplande query die dagelijks een verrijkte “clicks_to_events”-tabel wegschrijft. Dat scheelt querykosten en voorkomt inconsistente logica tussen analisten.
Voor wie deze structuur nog moet opzetten binnen een bredere campagne, is het de moeite waard om eerst te kijken naar hoe je een Google Ads-campagne structureert, zodat de campagnenamen en labels die je in BigQuery terugziet ook daadwerkelijk bruikbaar zijn voor segmentatie.
Wat betekent ‘Data Not Available’ en hoe vul je dat aan?
Wie met Fresh Daily exports werkt, ziet met enige regelmaat het label “Data Not Available” opduiken in het traffic source veld. Dat gebeurt omdat de dagelijkse export vaak eerder wordt gegenereerd dan het moment waarop Google Ads alle klikgegevens definitief heeft verwerkt. Het gevolg: een deel van je GCLID’s ontbreekt op de dag zelf, wat je CPA-berekening voor die periode vertekent.
Google raadt een backfill-proces aan om dit gat te dichten:
- Bepaal eerst een completeness-signal: een moment waarop je met zekerheid weet dat de Ads-data compleet is, meestal enkele dagen na de oorspronkelijke exportdatum.
- Identificeer welke GCLID’s in je GA4-tabel als “Data Not Available” gemarkeerd staan.
- Haal de ontbrekende traffic source-informatie opnieuw op via de Google Ads API en join die terug in je bestaande tabellen.
Voor wie dit niet handmatig wil blijven doen, beschrijft Google een automatiseringspatroon met een Pub/Sub-trigger die een Cloud Run functie aanroept zodra nieuwe data binnenkomt, en die functie voert vervolgens de join en update in BigQuery uit, zoals toegelicht in de gids over het backfillen van Ads-traffic source data. Bouw hier vroeg in je implementatie een monitoringcheck bij die het percentage “Data Not Available”-rijen per dag rapporteert. Loopt dat percentage plots op, dan is dat vaak het eerste signaal dat er iets mis is met de transfer zelf.
Welke queries en metrics leveren direct waarde op voor leadgeneratie?
Voor B2B-leadgeneratie draait alles om één vraag: wat kost een echte, gekwalificeerde lead per campagne en per zoekwoord? Dat bereken je door de klik en kostendata uit Ads te combineren met geverifieerde lead-events, idealiter aangevuld met een CRM-import die aangeeft welke leads daadwerkelijk zijn opgevolgd.
Een paar concrete bouwstenen die je dagelijks of wekelijks wilt draaien:
- Cost per lead per campagne: totale kosten uit
ads_ClickStats_gedeeld door het aantal gematchte, geverifieerde leadevents uit GA4. - Leadkwaliteit per zoekwoordgroep: koppel CRM-matchvelden zoals lead-ID of geverifieerd telefoonnummer aan de GCLID-keten, zodat je ziet welke zoektermen niet alleen veel maar ook kwalitatief goede leads opleveren.
- Time-to-contact: de tijd tussen leadinzending en eerste opvolging door sales, gekoppeld aan de oorspronkelijke advertentiebron. Trage opvolging bij een dure zoekwoordgroep is vaak een groter probleem dan de advertentie zelf.
- Validatiefilters: sluit test-inzendingen, interne IP-adressen en duidelijk foutieve e-mailadressen uit voordat je conversieratio’s berekent.
Een aanvullende stap die vaak wordt overgeslagen: bewaar een verrijkte “leads”-tabel waarin BigQuery-conversies al gematcht zijn met CRM-velden zoals lead_id en phone_verified. Dat versnelt niet alleen je dagelijkse rapportage, het beperkt ook de querykosten omdat je niet telkens de volledige ruwe dataset opnieuw hoeft te doorzoeken, zoals ook naar voren komt in Google’s toelichting op het combineren van UI- en BigQuery-data. Wie de vertaalslag van deze cijfers naar een concreet rendement wil maken, vindt aanvullende rekenmethodes in de gids over ROI berekenen voor Google Ads-campagnes.
Hoe voorkom je onnodige BigQuery-kosten?
BigQuery rekent apart voor opslag en voor het uitvoeren van queries, en dat tweede loopt snel op als je query’s niet gericht zijn. Filter altijd op partities (de event_date of importdatum) voordat je een query op grote schaal uitvoert, en gebruik clustering op velden zoals campagne-ID om scans verder te beperken.
Een paar zaken om vooraf te regelen:
- Stel cost alerts in via je Google Cloud project, zodat een onbedoelde full table scan niet ongemerkt een rekening van honderden euro’s veroorzaakt.
- Houd rekening met exportlimieten: standaard GA4-property’s kennen een grens van 1 miljoen events per dag voor dagelijkse exports, terwijl streaming exports geen limiet kennen, zoals Google aangeeft in het supportartikel over BigQuery-export. Voor 360-accounts met hogere volumes is streaming vaak de betere keuze.
- Test nieuwe query’s altijd eerst in een apart ontwikkelproject met een kleine datumrange, voordat je ze op productieschaal loslaat.
Pro-tip: Draai je zwaarste query’s als geplande, geïncrementeerde taken die alleen de nieuwste partitie verwerken, in plaats van elke keer de hele geschiedenis opnieuw te scannen.
Implementatiechecklist: van inschakelen tot dagelijkse routine
De volgorde waarin je dit opzet bepaalt grotendeels of je binnen een paar weken bruikbare data hebt, of maanden achter foutmeldingen aanloopt.
- Schakel de GA4 BigQuery-export in en kies bewust voor dagelijkse of streaming export, afhankelijk van je volume.
- Configureer de Google Ads Data Transfer Service met de juiste rechten en dataset, en controleer de eerste lading op volledigheid.
- Valideer of GCLID’s daadwerkelijk in
collected_traffic_sourceterechtkomen; ontbreken ze structureel, dan zit er een lek in je linking tussen Ads en Analytics, zoals ook toegelicht in het Analytics-supportartikel over het koppelen van Ads en Analytics. - Richt het backfill-proces in voor “Data Not Available”-gevallen, inclusief monitoring op het dagelijkse percentage ontbrekende records.
- Bouw de join met je CRM-export, zodat leads herkenbaar zijn tot op het niveau van geverifieerde contacten.
- Draai testqueries die steekproefsgewijs controleren of kosten, kliks en leads logisch op elkaar aansluiten.
- Zet een dagelijkse completeness-check en een maandelijkse schema-check op de Ads API in je routine.
Wie deze stappen wil vertalen naar een terugkerend rapportageritme, vindt een praktische aanpak in de gids over Google Ads-rapportage opstellen.
Waarom Adworth deze aanpak adviseert voor B2B-leadgeneratie
Bij Adworth draaien we Google Ads-campagnes handmatig, met SKAG-structuren en strikt gescheiden exact en phrase zoekwoorden. Die precisie op campagneniveau is pas volledig bruikbaar als je ook op databniveau weet welke zoekwoordgroep welke leadkwaliteit oplevert, niet alleen welk klikvolume.
In de praktijk zien we bij B2B-dienstverleners telkens hetzelfde patroon: de GA4-interface toont een keurige conversieratio, maar zodra je de ruwe BigQuery-data naast het CRM legt, blijkt een aanzienlijk deel van die “conversies” nooit een geverifieerd contact te zijn geworden. Server-side tagging via GTM en GA4, gecombineerd met de GCLID-join die dit artikel beschrijft, is de enige manier om dat verschil zichtbaar te maken en er vervolgens op te sturen in je biedingen.
Voor organisaties die overwegen dit zelf te bouwen: het is arbeidsintensief, vooral de backfill-automatisering en het onderhoud van schema-wijzigingen. Wie die tijd niet structureel kan vrijmaken, kiest vaak voor een specialist die dit als vast onderdeel van het campagnebeheer meeneemt. Meer over hoe wij dit voor B2B-dienstverleners inrichten, staat in ons artikel over Google Ads-strategieën voor B2B-dienstverleners.
— Arno Kooijman
Hulp nodig bij implementatie en dagelijks beheer?
Er zijn bureaus die Google Ads overlaten aan geautomatiseerde biedstrategieën; sommige specialisten bouwen de GA4 BigQuery-koppeling en de GCLID-attributie zelf op, en sturen campagnes dagelijks handmatig bij op basis van die data, niet op basis van een algoritme dat leadkwaliteit niet kan zien.
Er wordt uitsluitend gewerkt voor leadgeneratie, nooit voor webshops of Shopping-campagnes, en met maximaal 25 klanten tegelijk onder persoonlijke regie. Dat betekent dat implementatie van server-side tracking, de BigQuery-koppeling en het opzetten van SKAG-structuren geen los project is dat aan een junior wordt overgedragen, maar onderdeel van hetzelfde account dat ook je biedingen beheert. Bekijk het volledige aanbod aan SEA- en Analytics-diensten en vraag een kennismaking aan om te bespreken hoe jouw huidige GA4-opzet aansluit op een leadgerichte CPA-analyse. Voor bedrijven die worstelen met budget dat wegvloeit zonder bruikbare leads, is het artikel over waarom je Google Ads-budget verdampt zonder een goede lead een goed startpunt om te bepalen waar het probleem precies zit.
Bronnen
Voor wie dieper wil graven in de technische details, zijn dit de bronnen waarop de meeste implementaties in dit artikel steunen: de Google Cloud documentatie over de Ads-transfer voor de tabelstructuur, de toelichting op verschillen tussen UI en BigQuery voor attributievraagstukken, de gids met basisqueries voor de GCLID-join, en de backfill-gids voor het oplossen van ontbrekende traffic source-data. Ook het partnerartikel over het herkennen van afwijkend verkeer in GA4 is relevant zodra je merkt dat je datakwaliteit onverklaarbare pieken vertoont.
- Google Cloud documentation — Google Ads transfer
- Bridge the gap between the Google Analytics UI and BigQuery export | Google for Developers
Veelgestelde vragen
Wat is het verschil tussen GA4-data in BigQuery en in de interface?
BigQuery bevat ruwe, ongemodelleerde events, terwijl de GA4-interface gemodelleerde data toont inclusief Google Signals en attributiemodellen. Dat verklaart waarom cijfers zelden exact overeenkomen, zoals Google zelf uitlegt.
Hoe koppel ik Google Ads-klikdata aan GA4-events?
Je joint het gclid-veld uit collected_traffic_source in de GA4-export met het gclid-veld in de ads_ClickStats_-tabel van de Ads-transfer. Dedupliceer eerst op click-timestamp om dubbele attributie te voorkomen, zoals beschreven in de gids met basisqueries.
Wat kost het om GA4-data naar BigQuery te exporteren?
Het transfereren van GA4-data naar BigQuery zelf is gratis; je betaalt alleen voor opslag en het uitvoeren van query’s binnen BigQuery, zoals Google Cloud aangeeft. Filteren op partities en clustering houdt die kosten beheersbaar.
Waarom zie ik ‘Data Not Available’ in mijn GA4-exporttabel?
Dat komt doordat een dagelijkse export soms eerder wordt aangemaakt dan het moment waarop Google Ads alle klikgegevens definitief heeft verwerkt. Een backfill-proces met een completeness-signal en een automatisering via Pub/Sub en Cloud Run vult die gaten later alsnog aan, zoals toegelicht in de backfill-gids van Google.
Kan Adworth helpen bij het opzetten van deze BigQuery-koppeling?
Adworth bouwt server-side tracking en GA4 BigQuery-koppelingen op als onderdeel van doorlopend campagnebeheer voor leadgeneratie, niet als losstaand project. Prijzen voor implementatie en beheer zijn op aanvraag beschikbaar via de dienstenpagina.